Distill
你自己拥有的书,逐章摘要,放在一个记得你读到哪里的阅读器里。
Flask, SQLite, Claude Code, vanilla JS
已开源访问 ↗
你自己拥有的书,逐章摘要,放在一个记得你读到哪里的阅读器里。
Flask, SQLite, Claude Code, vanilla JS
一个私人阅读应用,摘要都来自你自己的电子书。一组 Claude Code 智能体逐章读完整本书,阅读器提供进度同步、朗读和 Kindle 模式。
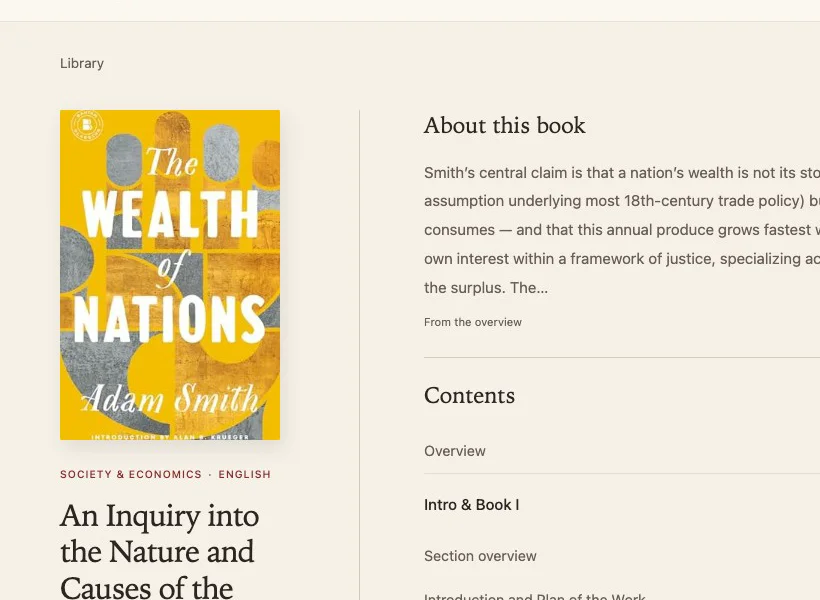
视频里用的是《国富论》,一本公版书,在我书库的一份本地副本上录制。线上应用是私人的,需要登录。
值得读的书大多很长,而我读的书大多是自己已经买下的电子书。一份可信的摘要必须来自书本身:真实的章节、书里自己的例子和数字,不掺杂任何别处记来的东西。通用的摘要服务做不到这一点,也覆盖不了我自己书架上的书。
我原本就在给自己的书做逐章摘要,但它们只是一个个独立网页:在 Kindle 上很难读,不会记住读到哪里,也看不出哪些书读了一半。
一切都从你自己拥有的文件开始。Distill 从不凭记忆写摘要:没有电子书,流水线就停下来要文件。
这些摘要始终是私人的:来自我自己拥有的书,只供我自己阅读,需要登录才能看。
book-summary 这个 Claude Code 技能,在我自己的电脑上用并行智能体运行。Kindle。它的浏览器是一个很旧的 WebKit:不支持现代 JavaScript,也不支持 WebP 和 AVIF 图片。Kindle 页面在服务器上渲染,只配一个老式的小脚本;图片存成 JPEG 或 PNG;操作用 Kindle 自己的手势;控件比电脑上大 2.5 倍,在墨水屏上才看得清。