水墨中文 InkChinese
我给 6 岁的孩子做的中文伴读应用,课程设计以阅读研究为依据。
React, TypeScript, Python, SQLite, hanzi-writer
已上线
我给 6 岁的孩子做的中文伴读应用,课程设计以阅读研究为依据。
React, TypeScript, Python, SQLite, hanzi-writer
一个 iPad 阅读应用,给在家听得懂中文、但刚开始学认字的孩子。它沿用一套真实教材的顺序,每个故事都是一节分四步的短课:听、字、读、复。
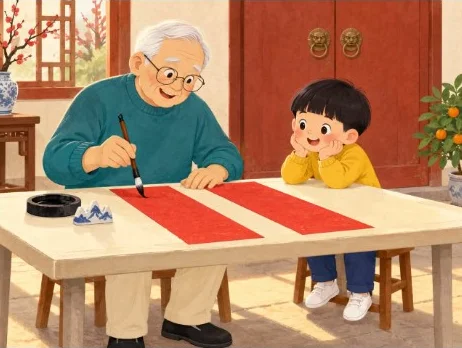
视频里的故事是《门上的春联》,用测试账号录制。这个应用只给我们家用,需要 Google 登录。
我家 6 岁的孩子在家听得懂、也会说中文,但才刚开始认字。这正是美国华裔传承语学习者的典型情况:口语词汇量大,识字能力弱。对美国中英双语儿童的研究发现,口语能力跟家里的交流有关,而阅读能力跟接触文字的多少、以及拼音或注音的练习有关(Ke, Xia & Zhang, 2023)。
所以瓶颈不在词汇,而在于把汉字和孩子已经会说的音和义连起来。字卡只教字,没有故事;有声书只讲故事,不让孩子动手。我想要的是孩子自己就能完成的短课,用孩子平时会说的词,一个字一个字地把阅读能力建立起来。
每个故事就是一节课,分四步,对应屏幕上方的四个按钮。前一步完成,后一步才会打开。
设计之前,我先读了儿童学习中文阅读的研究,并给每条发现的证据强度打了分。每一步都对应一条具体的发现。
阅读应用最难的是书目,大部分功夫都花在了写故事、排故事的规则上。
沿用一套真实教材。 主线是暨南大学《中文》,很多海外周末中文学校在用这套书。它的五册就是应用的五个级别,必修课文按教材原有顺序排列,配套故事放在后面的选修单元里。完成一个级别的全部必修课,就会解锁下一级的课文和故事。选修故事永远不会挡住孩子前进。
每个级别两张字表。 每册都有一张明确教授的生字表(第一册 133 字,到第二册累计 275 字),还有一个更大的字集,就是课文里实际出现过的字(第一册 236 字,到第二册累计 433 字)。课程从第一张表里教、从第一张表里考;新写的故事则控制在第二个字集之内,这样语言自然,又不超出孩子见过的范围。
每个新故事都要满足覆盖率规则。 舒适的独立阅读大约需要认识 95–98% 的词(Hu & Nation, 2000;被广泛采用,但仍有争议)。配套故事的目标是 98% 的字来自本级字集,硬性底线是所有字次的 95%,以及不重复字的 95%。第二条底线防止一个故事用大量简单重复来掩盖很多生字。一级故事最多只能有 1 个字集外的字,二级最多 2 个,而且每个都要注明所在的词和意思,并有音频或图画辅助。
按级别限制长度和句长。
| 一级故事 | 二级故事 | |
|---|---|---|
| 正文长度 | 10–50 字 | 51–160 字 |
| 不重复字 | 最多 30 个 | 最多 60 个 |
| 最长句子 | 12 字 | 24 字 |
| 故事结构 | 一个熟悉的场景,重复中带一点变化 | 一个目标或问题,两三个动作,看得见的结果 |
| 理解检查 | 是谁、是什么;对应一个动作 | 排出事情的顺序;说出文中写明的一个原因 |
复习写进故事里。 每个故事挑 3–5 个已经学过的字,自然地出现 2–4 次,并在 3–5 个故事里反复出现。每页最多 16 个字。
翻页跟着故事走,不跟着标点走。 每一页是一个有意义的时刻:一个动作、一个发现、一次心情的变化。铺垫和揭晓放在不同的页上,反应和引起它的动作放在同一页。故事先画分镜、读出声,然后才做插图和配音。
这些规则不是什么。 这些限制是我的编辑选择,依据上面的研究,并对照我自己孩子的阅读情况做了检验。它们不是正式发布的水平标准,老师和母语者的审读还没有做。
让每一页前后一致。很多汉字是多音字,拼音、朗读、点字发音和小测验,都必须用这句话里正确的那个读音。一次全目录检查修正了近 200 本书里的读音。现在的规则是:先给整篇故事标注读音,再分页,这样分页就不会丢掉上下文。